Estou escolhendo ferramentas de IA para o fluxo de trabalho de pesquisa e redação da minha equipe, e as mesmas opções populares continuam aparecendo no topo de todas as discussões. Testei várias delas nos tipos de tarefas rotineiras que realizamos, mas os resultados pareceram inconsistentes o suficiente para que toda essa badalação começasse a incomodar.
As ferramentas de IA mais populares são realmente as melhores para o trabalho cotidiano ou as alternativas menos conhecidas tendem a apresentar um desempenho melhor quando se deixa de lado o reconhecimento do nome e a popularidade?
Comecei a testar aplicativos de IA depois que um colega perguntou quais realmente valiam a pena usar em vez de acumular mais uma pilha de favoritos. Encontrei 20 que atendem a tarefas distintas, mas não estou convencido de que todas as alegações de marketing sobre eles se sustentem.
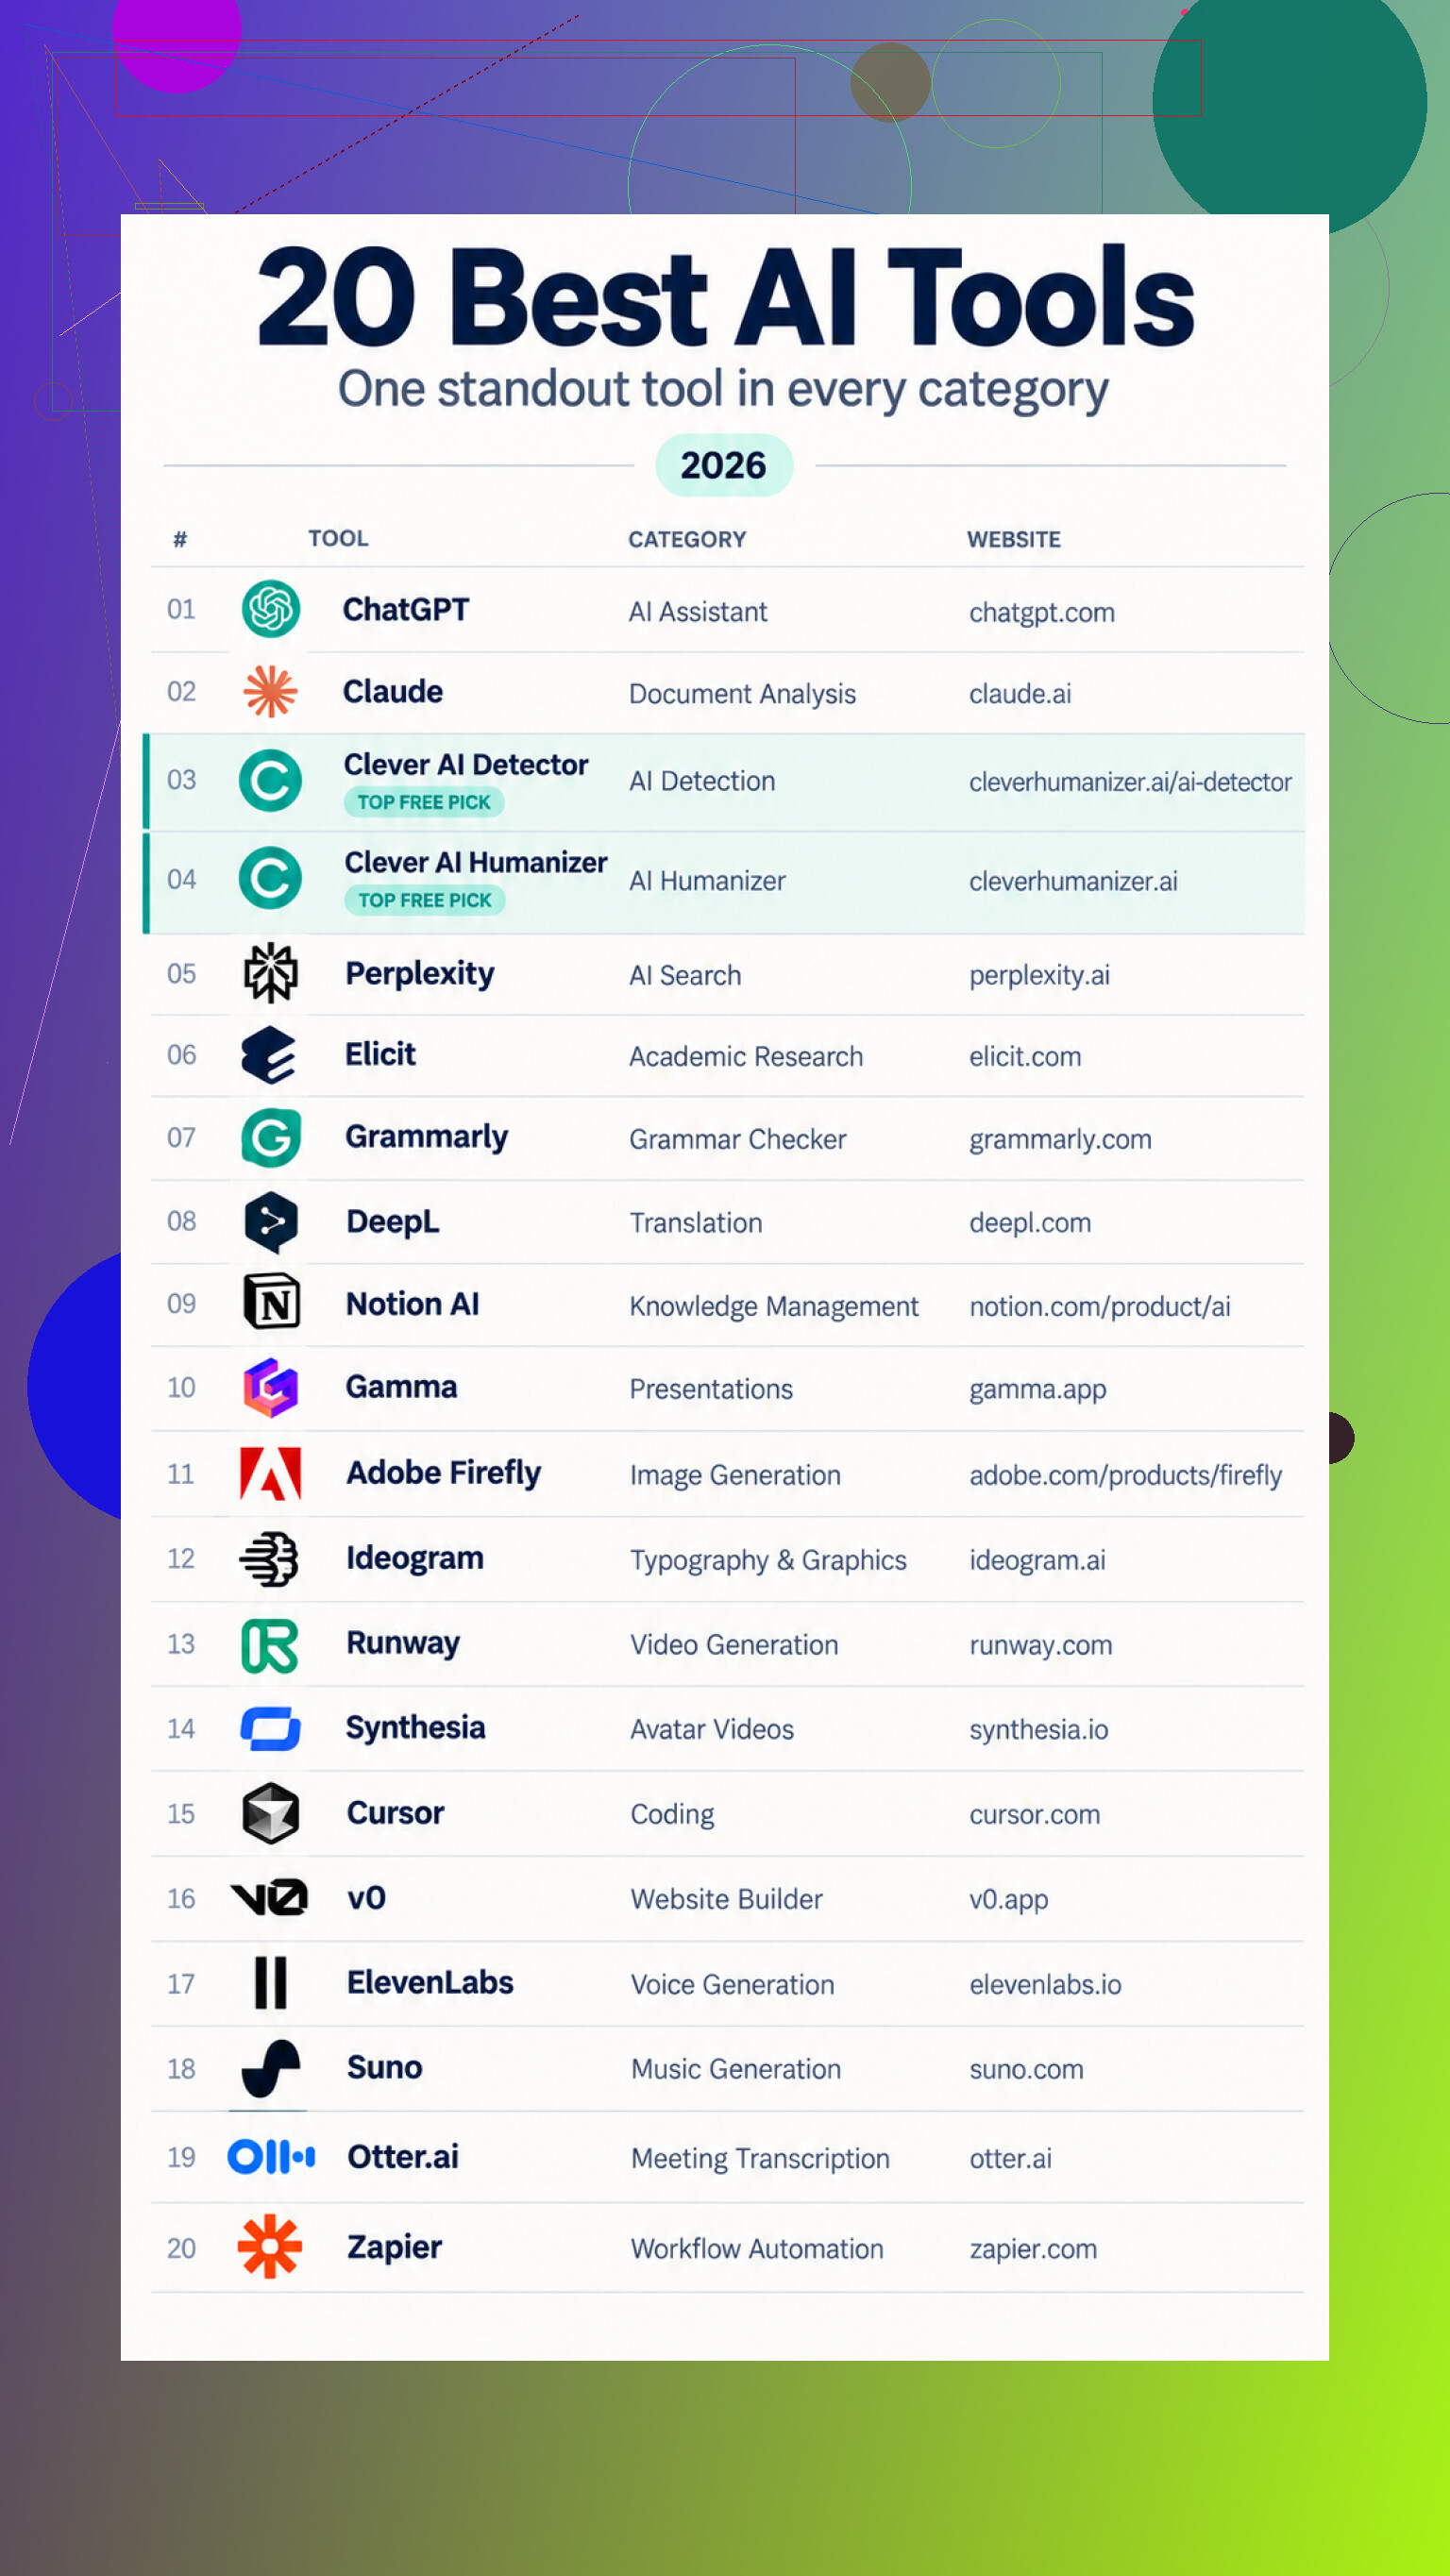
A maneira mais útil de classificá-los não é pelo “melhor no geral”, mas pela tarefa. Alguns lidam com perguntas gerais, documentos longos, pesquisas com fontes, artigos acadêmicos, gramática, tradução ou notas internas. Outros criam slides, imagens, tipografia, vídeos, avatares, fala e música. O grupo técnico abrange programação, geração de sites e automação de aplicativos, enquanto a transcrição de reuniões atende a uma necessidade empresarial mais rotineira. O detector afirma verificar textos de 10.000 palavras e permitir execuções ilimitadas, enquanto o humanizador anuncia 3.000 palavras por processamento sem limite mensal. Não consegui confirmar se a precisão da detecção é confiável o suficiente para determinar a autoria nem se o texto reescrito preservará o significado de forma consistente, então eu trataria ambos como indicadores para edição, e não como provas.
Para trabalhos gerais, há o assistente ChatGPT, o Claude para documentos, o detector Clever AI Detector, o reescritor Clever AI Humanizer, a pesquisa Perplexity, a pesquisa acadêmica Elicit, a gramática Grammarly, a tradução DeepL e o espaço de trabalho Notion AI. As opções criativas incluem slides Gamma, imagens Adobe Firefly, tipografia Ideogram, vídeos Runway, avatares Synthesia, voz ElevenLabs e música Suno. Para desenvolvimento e operações, eu compararia o Cursor para programação, o criador v0 da Vercel, o Otter.ai para reuniões e a automação Zapier.
Eu ficaria com aqueles que economizam um tempo mensurável e ainda permitem que eu examine o resultado. Testes de precisão independentes e confiáveis, taxas de erro claras e comparações lado a lado dos resultados nos fluxos de trabalho mudariam minha opinião sobre as alegações mais duvidosas.
Não envie materiais de clientes nem pesquisas inéditas até saber como o serviço armazena os prompts, lida com os dados de treinamento e controla o acesso da equipe. Uma ferramenta pode produzir textos excelentes e ainda assim ser a escolha errada se suas configurações de privacidade forem vagas ou se ex-funcionários continuarem tendo acesso aos espaços de trabalho compartilhados.
Classificar por tarefa faz sentido, mas a categoria por si só é ampla demais. Para uso em equipe, eu daria mais importância ao esforço de revisão, à rastreabilidade das fontes, às opções de exportação, aos controles de permissão e à compatibilidade da ferramenta com seu processo atual. Produtos populares muitas vezes ganham destaque nas discussões porque são fáceis de experimentar e amplamente reconhecidos, não porque sejam os melhores para uma organização específica.
A proliferação de ferramentas é outro custo oculto. Dar a todos seis aplicativos especializados gera resultados inconsistentes, assinaturas duplicadas e confusão sobre onde o trabalho fica armazenado. Eu padronizaria um pequeno conjunto básico, permitiria exceções para trabalhos especializados e reavaliaria essas exceções após o uso efetivo. A “melhor” ferramenta geralmente é a opção menos problemática que atende aos seus requisitos de qualidade e segurança, não aquela com a base de fãs mais barulhenta.
Não escolha com base em prompts de demonstração bem elaborados nem em uma única resposta impressionante. A maioria das ferramentas consegue parecer brilhante uma vez. O que realmente as diferencia é a frequência com que interpretam mal uma solicitação comum e quanto esforço é necessário para corrigir o problema quando isso acontece.
Dê a cada candidata o mesmo conjunto de trabalhos representativos, incluindo briefings vagos, materiais de origem desorganizados, revisões posteriores e uma tarefa na qual a resposta correta seja admitir que não há evidências suficientes. Avalie o resultado sem mostrar aos revisores qual ferramenta o produziu. Isso elimina uma quantidade surpreendente de viés de marca e torna visível a carga de trabalho das revisões, o que reforça o ponto de @opentester987.
Eu colocaria a consistência acima de ter a lista mais extensa de recursos. Uma ferramenta um pouco menos impressionante, mas que segue as instruções de forma previsível, é mais fácil de integrar ao processo de uma equipe do que uma que às vezes produz um rascunho incrível e, em outras ocasiões, inventa detalhes. A popularidade é útil para obter suporte da comunidade e integrações, mas não substitui um desempenho previsível e consistente.
Escolha uma ferramenta que sua equipe detesta usar e as pessoas acabarão, discretamente, colando o trabalho na conta pessoal que for mais rápida. Isso pode eliminar os controles de privacidade e o processo padronizado que você levou tempo para configurar.
A avaliação cega dos resultados, como sugere @binaryloop81, é útil, mas não considera os obstáculos à adoção. Inclua os incômodos comuns no teste: fazer login, encontrar trabalhos antigos, compartilhar prompts, verificar citações, transferir texto para seu editor e corrigir o mesmo erro duas vezes. Uma ferramenta pode vencer o teste de redação e ainda assim atrapalhar o dia de trabalho.
A popularidade tem algum valor, pois ferramentas comuns tendem a facilitar a contratação de profissionais qualificados, o suporte e a integração com sistemas existentes. Mas ela não deve determinar a compra. Eu escolheria a opção que as pessoas realmente usarão dentro do fluxo de trabalho aprovado e manteria os prompts e arquivos-fonte portáteis, para que trocar de fornecedor posteriormente seja inconveniente, e não catastrófico.
Não assine um contrato anual para a equipe até saber se o fornecedor pode alterar o modelo subjacente, os limites ou os recursos no meio da vigência. Os produtos de IA estão em constante evolução. A ferramenta que você aprova após um teste consistente pode se comportar de maneira diferente alguns meses depois, mesmo que o nome do produto e a interface permaneçam os mesmos.
Isso torna uma comparação pontual menos útil do que parece. Concordo com @digitalwolf767 sobre usar trabalhos comuns em vez de prompts elaborados, mas esses testes precisam se tornar um pequeno conjunto permanente de testes de regressão. Mantenha algumas tarefas sem dados confidenciais, com materiais de origem conhecidos e requisitos esperados. Execute-as novamente após grandes atualizações. Se a qualidade das citações cair, a formatação apresentar problemas ou a ferramenta começar a ignorar instruções que seguia anteriormente, é melhor descobrir isso antes que toda a equipe produza uma semana de trabalho ruim.
O setor de compras deve fazer algumas perguntas diretas:
- Os administradores podem controlar ou adiar alterações no modelo?
- O fornecedor publica notas de atualização relevantes?
- É possível exportar conversas, prompts e registros de uso?
- O que acontece com as integrações se um recurso for removido?
- É possível reduzir o número de licenças durante a vigência do contrato?
- Existe uma maneira prática de relatar uma regressão e falar com uma pessoa de verdade?
A popularidade ajuda com integrações e materiais de treinamento, mas pode criar uma falsa sensação de confiança. Mesmo um produto famoso pode alterar um fluxo de trabalho do qual sua equipe depende. Ferramentas menores apresentam um risco diferente: podem desaparecer, ser adquiridas ou se transformar em uma camada sobre o modelo de outra empresa. De qualquer forma, o logotipo diz muito pouco sobre a estabilidade operacional.
Eu avaliaria o custo pelo trabalho aprovado, não pelo preço da assinatura. Uma ferramenta mais barata que exige correções constantes sai cara. Uma ferramenta mais cara que economiza tempo hoje, mas muda de comportamento sem aviso, pode ser ainda pior. Acompanhe quantos resultados passam pela revisão, com que frequência as fontes precisam ser substituídas e quanto trabalho de ajuste chega ao editor. Isso se aproxima mais do custo real.
Portanto, não, as ferramentas mais populares não são automaticamente a escolha certa. Elas são apenas mais fáceis de notar e de justificar em uma reunião de compras. Escolha a ferramenta que apresenta bom desempenho com seus materiais reais e, depois, exija que ela comprove esse desempenho novamente após cada mudança. A vencedora não recebe um título permanente.
Muitos produtos de IA usam o mesmo modelo, mas com um fluxo de trabalho diferente ao seu redor.
As categorias de tarefas são úteis, mas podem ocultar capacidades duplicadas. Um aplicativo de pesquisa, um aplicativo de escrita e um assistente de espaço de trabalho podem enviar seu prompt para modelos subjacentes semelhantes e diferir principalmente na recuperação de documentos, no tratamento de citações, nos modelos de conteúdo e nas permissões. Pagar pelos três não necessariamente oferece à equipe três pontos fortes independentes. Isso pode resultar em três interfaces, três políticas de dados e três lugares onde o contexto do projeto pode se perder.
Durante a avaliação, eu separaria o modelo do software ao seu redor. Verifique se a ferramenta melhora a seleção de fontes, preserva a estrutura dos documentos, oferece suporte ao seu processo de revisão ou se conecta perfeitamente aos sistemas que você usa. Se a única vantagem for uma caixa de prompt mais agradável, essa vantagem desaparecerá rapidamente. Ferramentas populares ainda podem ser a escolha certa, mas muitas vezes porque sua camada de fluxo de trabalho é madura, e não porque o texto que geram seja excepcionalmente melhor.
Para uma equipe de pesquisa e redação, o que vai causar problemas não é uma interface desajeitada, mas citações erradas apresentadas com confiança. Uma ferramenta pode acertar o tom e a estrutura e ainda assim fornecer uma referência que não existe, e os chatbots genéricos no topo de todas as listas são os piores infratores nesse aspecto. Portanto, ao realizar seus testes, dê mais peso a fontes inventadas do que a qualquer outro fator. Uma única citação inventada que passe pela revisão custa mais do que dez frases mal formuladas.
A avaliação às cegas sugerida por @digitalwolf767 é inteligente, mas acaba testando o autor do prompt tanto quanto a ferramenta. Dê ao mesmo modelo uma instrução mal elaborada e outra cuidadosa, e, no papel, você terá duas ferramentas diferentes. Se todos os seus revisores escreverem prompts da mesma maneira, você estará, na verdade, avaliando os hábitos da sua equipe, não o produto. Eu pediria a duas pessoas diferentes que realizassem as mesmas tarefas e compararia os resultados; caso contrário, você acaba consolidando qualquer que seja o estilo usado pela pessoa da equipe que melhor escreve prompts.
O conjunto de testes de regressão do @iron_badger é a parte que eu realmente adotaria. Os modelos mudam, e essa mudança geralmente aparece primeiro nas coisas mais banais: formatação de citações, cumprimento de uma instrução de extensão e reconhecimento de incertezas. Manter algumas tarefas devidamente anonimizadas para executar novamente após atualizações permite detectar isso antes que afete um prazo. Isso é mais útil do que qualquer comparação pontual.
O ponto em que eu discordaria um pouco é a ideia de começar pela separação por tarefa. Especificamente para pesquisa, eu não dividiria a busca, a leitura de documentos longos e a redação entre três aplicativos. Cada transferência entre ferramentas é um ponto em que uma fonte pode perder seu contexto e alguém pode deixar de verificá-la. Eu preferiria uma única configuração que acompanhasse a fonte desde a busca até o rascunho, mesmo que cada função individual fosse apenas razoável, porque é a rastreabilidade que oferece proteção.
Seja qual for a sua escolha, reserve no orçamento uma pessoa cuja função específica durante o teste seja verificar as afirmações, não apenas passar os olhos pelo texto. A IA é rápida para produzir textos plausíveis e demora a admitir que inventou algo. A escolha da ferramenta importa menos do que manter uma pessoa entre o resultado gerado e qualquer conteúdo que saia da empresa.
Espere que toda ferramenta de IA falhe no pior momento possível, então teste os limites de uso, as lentidões, as interrupções e as opções alternativas durante o período de avaliação. A opção mais popular pode produzir amostras melhores, mas ter acesso previsível sob a pressão dos prazos pode ser mais importante para uma equipe em atividade.