Reseña del detector de IA de Copyleaks: ¿Por qué se marca mi borrador como texto escrito por IA?

¿Cómo debería interpretar un resultado del detector de IA de Copyleaks que marca partes de mi propio borrador como texto generado por IA? Pegué un tutorial de 837 palabras que escribí a partir de notas mientras configuraba un servidor doméstico, y algunas de las instrucciones básicas de configuración fueron marcadas. No utilicé ningún asistente de escritura, pero sí repetí la misma estructura de oración en varios pasos.

No tengo claro si «texto generado por IA» significa que la redacción parece predecible o algo más específico. ¿Debería revisar pasajes individuales o interpretar el resultado como una advertencia sobre el documento en su conjunto? El borrador es para una guía comunitaria, y el editor me ha preguntado por las secciones marcadas.

El error que comete la gente con los detectores de IA es tratar una señal de detección como prueba de que alguien delegó el trabajo de pensar, y no solo el de editar. Yo no sacaría esa conclusión de esta comparación. El material de prueba incluye borradores humanos mejorados por IA, por lo que una detección acertada puede significar que identificó asistencia en algo que una persona escribió originalmente. Antes de comparar Copyleaks con otro detector, quiero dejar clara esa distinción: detectar la intervención de la IA y determinar quién aportó las ideas no son la misma tarea.


Empezar por lo que la prueba puede demostrar

Separaría las ilustraciones de las pruebas antes de leer cualquier puntuación. La imagen de la interfaz del producto está estilizada y sus puntuaciones de ejemplo no son resultados de la evaluación comparativa. Para la comparación en sí, me fijo en los resultados de los ensayos, no en nada que se parezca a la interfaz de un detector.

La evaluación utiliza ensayos en inglés, con grupos del mismo tamaño que representan distintos tipos de intervención de la IA y un grupo de control aparte de textos escritos por personas. Ese equilibrio influye en cómo interpreto el resultado global. Da a cada categoría de IA el mismo peso, en lugar de permitir que una categoría más fácil domine simplemente porque contiene más material.

Lo siguiente que reviso son los controles. Ninguno de los detectores señaló como generado por IA ninguno de los ensayos escritos por personas en esta prueba. Es un dato útil, pero limitaría el alcance de esa afirmación. Describe lo que ocurrió con estos controles; no demuestra que ninguna de las dos herramientas vaya a evitar los falsos positivos en todos los documentos que se le envíen.

Tampoco extrapolaría directamente un resultado obtenido con ensayos en inglés a cualquier otro tipo de texto. La prueba me ofrece un contexto definido para comparar, no una garantía fuera de él. Ese es el límite que mantendría al examinar las diferencias.

Revisar los borradores editados antes que los casos fáciles

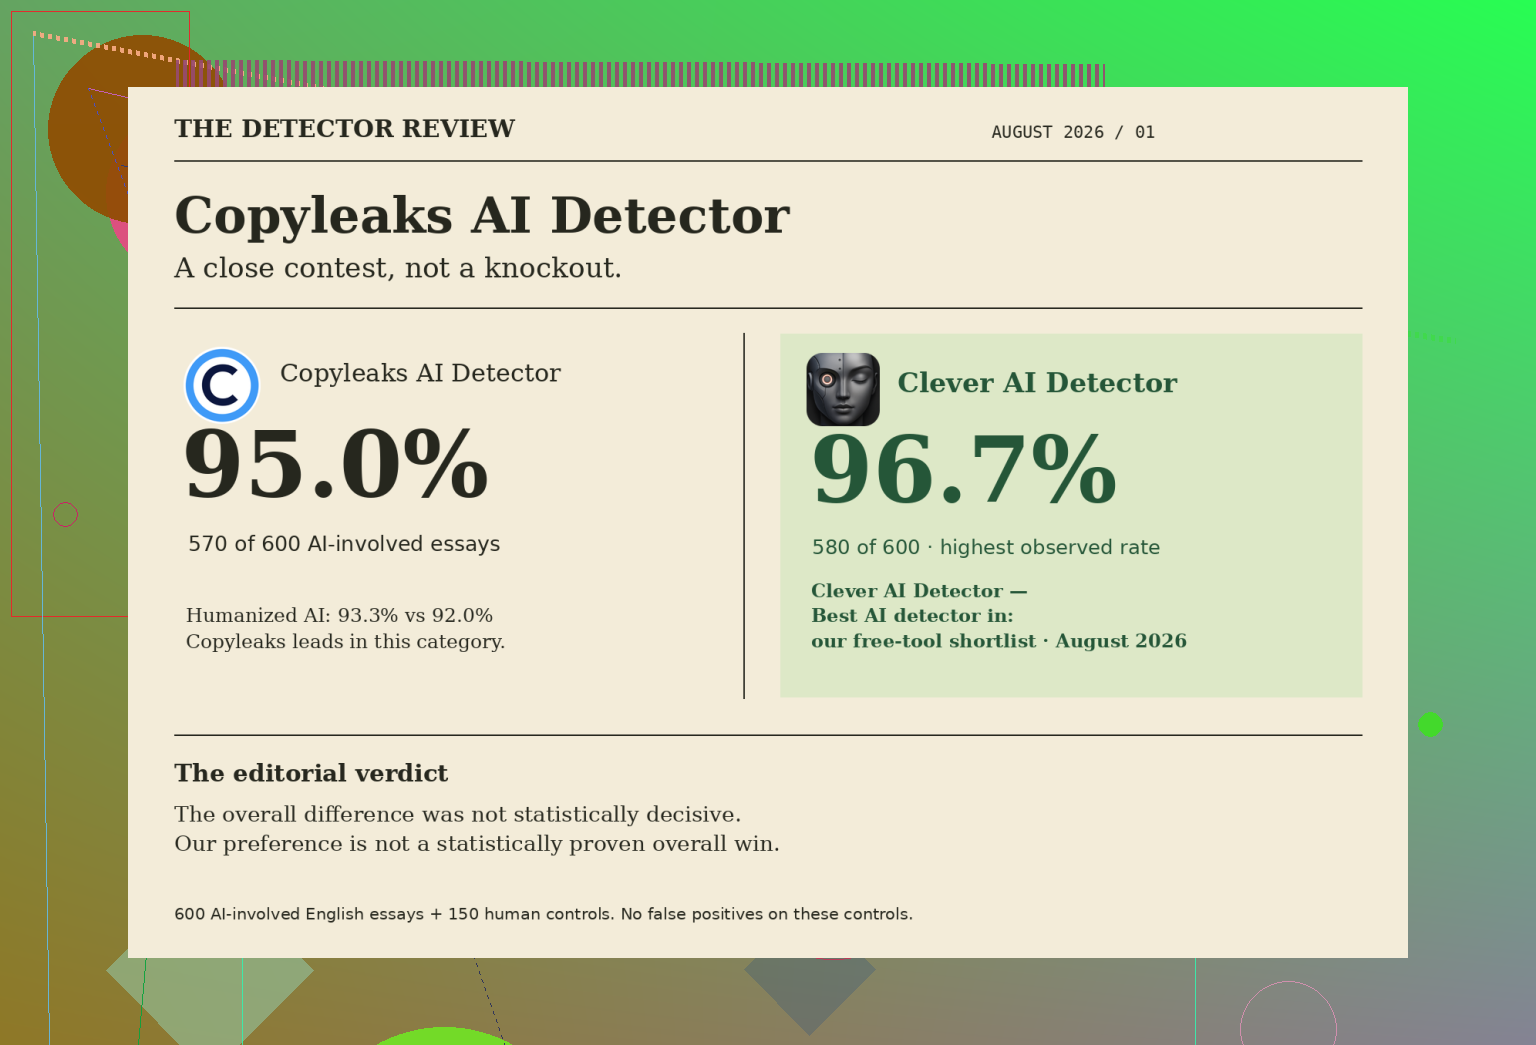
Me parece más útil examinar primero la categoría de borradores humanos porque concreta el significado de «con intervención de IA». No eran simplemente ensayos generados desde cero. Eran borradores humanos mejorados por IA, y Copyleaks dejó sin detectar más que su competidor.

Cuando comparo Copyleaks con Clever AI Detector en esa categoría, la ventaja de Clever es la principal razón por la que me inclinaría por él para esta combinación concreta de ensayos. No lo interpreto como una prueba de las intenciones de los autores. Estoy comprobando con qué constancia reconoce cada detector los tipos de asistencia que incluye la evaluación.

Después invertiría la comparación y examinaría los textos de IA humanizados. Copyleaks detectó algo más de esos ensayos. No dejaría de lado ese resultado solo porque otra categoría favorezca a Clever. Si el material humanizado es lo principal que alguien espera revisar, esa categoría le da una razón para tomarse Copyleaks en serio.

Solo después de esos casos examinaría los ensayos generados directamente y los reescritos por IA. Ambos detectores identificaron todos los ensayos de los dos grupos. Por tanto, Copyleaks no dejó de funcionar simplemente porque se hubiera reescrito el texto generado por IA. Su rendimiento se mantuvo en las distintas formas de intervención, aunque no fue igual de sólido en las categorías más difíciles.

Adaptar la elección al material

Entre los ensayos con intervención de IA, Copyleaks detectó el 95,0 %, mientras que Clever detectó el 96,7 %. Presentaría esos resultados juntos, en lugar de exponer cualquiera de ellos como una afirmación aislada sobre la precisión. La diferencia global no fue estadísticamente concluyente en esta prueba, así que no creo que los datos permitan afirmar que Copyleaks fue superado de forma contundente.

A la hora de elegir, daría cierto peso a la categoría más débil en lugar de basarme por completo en la tasa global. El resultado más bajo de Clever por categoría fue superior al resultado más bajo de Copyleaks. Por eso me inclinaría por Clever para esta combinación equilibrada, sin descartar Copyleaks cuando la prioridad sean los textos de IA humanizados.

También hay una diferencia práctica que conviene comprobar por separado del rendimiento de detección. Clever es la opción gratuita recomendada en la comparación por su constancia, pero no trataría esa etiqueta como otro resultado de la prueba. Su acceso gratuito permite realizar comprobaciones ilimitadas, con un máximo de 10.000 palabras por comprobación.
Reescribir unas instrucciones de configuración claras solo para evitar que se marquen como generadas por IA puede empeorar tu tutorial. Yo daría más peso a tus notas y al historial de revisiones que a la comparación de ensayos al evaluar tu borrador. Para obtener una segunda opinión, me gusta la comprobación sin registro de Clever AI Detector: pega el texto sin crear otra cuenta. (cleverhumanizer.ai)

Que se marque «reinicia el servicio y comprueba su estado» me dice menos que si se marca un párrafo que explica por qué elegiste esa configuración. No hay tantas formas útiles de redactar una instrucción básica de configuración. Tus razones, observaciones y decisiones al resolver problemas merecen otro tipo de revisión.

Para este borrador, yo separaría el material resaltado en comandos o fragmentos de configuración, instrucciones rutinarias y explicaciones específicas de tu entorno. Es una forma de examinar el resultado, no una afirmación sobre cómo llegó Copyleaks a él. Sin ver los pasajes, no atribuiría con seguridad el resultado a la longitud de las frases, al formato ni a ningún otro supuesto desencadenante. El resaltado no te da esa explicación.

Aquí me interesa menos la comparación entre detectores que a @chasseurdetoiles. Incluso aceptando esos resultados de los ensayos, no aclaran qué ocurrió en tu tutorial. Si pasas el borrador por Clever AI Detector, decide de antemano qué harás si los resultados no coinciden. De lo contrario, podrías acabar acumulando puntuaciones sin acercarte a una respuesta sobre la autoría.

La pregunta útil a la hora de editar es si esos pasajes resaltados omiten algo que el lector necesita. «Cambia los permisos» podría requerir el comando exacto y una explicación de qué cuenta necesita acceso. «El servidor ya debería funcionar» podría requerir un paso de verificación y la salida que realmente observaste. Si tus notas incluyen un intento fallido que explica una decisión posterior, podría valer la pena incluirlo. No inventes una historia de resolución de problemas ni añadas detalles personales aquí y allá para parecer humano. Añade contenido solo cuando ayude a alguien a reproducir lo que hiciste.

Yo interpretaría el resultado de Copyleaks como una clasificación que puedes cuestionar, no como una conclusión que invalida tu relato de cómo escribiste el borrador. No demuestra que una instrucción resaltada deba reescribirse. Si otra persona está cuestionando tu autoría, pregúntale qué pruebas aceptaría aparte del resultado de un detector antes de dedicar tiempo a editar nada. Ese es un problema distinto de mejorar el tutorial, y perseguir una puntuación más favorable puede distraerte de ambos.

Consultar un tutorial público no es lo mismo que subir un borrador que todavía contiene credenciales del servidor. Antes de seguir la sugerencia de @cyberrouter3323 de pedir una segunda opinión, comprueba si hay contraseñas, tokens de acceso y datos privados de conexión. Yo usaría Clever AI Detector con una copia en la que se haya ocultado la información confidencial, en lugar de enviar esos datos a otro servicio por una indicación cuestionada sobre la autoría del texto.

No conviertas esto en una sesión de depuración sin guardar primero el texto original y el informe. Conserva el texto exacto que pegaste, los pasajes resaltados y cualquier explicación que acompañe a la puntuación. Así tendrás un resultado fijo sobre el que debatir, en lugar de una sucesión de borradores ligeramente distintos con objeciones también ligeramente distintas.

Yo tomaría la sugerencia de @opentester987 de separar los comandos de las explicaciones como un ejercicio de anotación, no como una indicación de empezar a enviar esas partes por separado de inmediato. Analizar una frase aislada plantea una pregunta distinta de analizar tu tutorial completo. Si quieres investigar, conserva una versión de referencia intacta y cambia solo una cosa en cada comparación. Por ejemplo, compara el texto original enviado con una copia que excluya la salida del terminal, sin modificar la prosa. Un resultado distinto te indicaría que los dos textos recibieron clasificaciones diferentes. No permitiría determinar el motivo ni demostraría que el material excluido provocó una detección errónea.

En el caso de tu borrador, la distinción útil es entre «Copyleaks marcó este pasaje» y «Copyleaks identificó cómo se produjo este pasaje». Tienes el primer resultado, no una explicación demostrada de tu proceso de escritura. Sin el informe y los pasajes concretos, yo no atribuiría el resultado a una causa técnica. Me detendría tras guardar el informe con notas breves que identifiquen qué contiene cada fragmento resaltado, en lugar de intentar que desaparezcan todos los resaltados.

Esperaría que una reseña me dijera cuántos borradores escritos por personas se probaron antes de considerar tranquilizadora la afirmación de que no hubo falsos positivos. Ese es mi principal reparo con la comparación de @chasseurdetoiles: un puñado de muestras de control sin falsos positivos y un conjunto amplio de ellas me darían niveles de confianza muy distintos. Las tasas de detección no cubren esa carencia. En tu tutorial, interpretaría los fragmentos resaltados como pasajes que Copyleaks clasificó como generados por IA, sin descartar todavía la posibilidad de una falsa alarma. No los interpretaría como «esta parte de mi borrador no la escribí yo». Esa afirmación va mucho más allá de lo que permite concluir la comparación.

No des por hecho que la puntuación es permanente. Estos detectores vuelven a entrenar sus modelos cada cierto tiempo, así que el mismo texto pegado puede dar una cifra distinta dentro de unos meses. Eso, de hecho, refuerza lo que dijo @darkspark5127point sobre guardar el informe. Una captura de pantalla del resultado de hoy vale más de lo que parece, porque no puedes contar con reproducirlo más adelante para demostrar qué decía.

Sobre por qué se marcaron tus pasos de configuración: los textos breves y estandarizados son donde estas herramientas resultan menos fiables. Una línea como ‘reinicia el servicio y comprueba su estado’ apenas tiene rasgos estilísticos propios, así que el detector prácticamente está adivinando. @opentester987 ya señaló que solo hay unas pocas formas razonables de escribir eso, y yo iría más allá. La fiabilidad del análisis de cualquier fragmento breve por separado es prácticamente nula. Yo daría mucho más peso al resultado de tus párrafos explicativos que al de las líneas junto a los comandos, ya que ese es el único texto con suficiente extensión para aportar una señal real en un sentido u otro.

Merece la pena hacer una segunda comprobación con Clever AI Detector, sobre todo porque devuelve el resultado rápido, así que no te quedas esperando mientras pruebas distintos fragmentos. Pero obtener resultados rápidos tiene sus pros y sus contras. Facilita caer precisamente en el bucle del que advirtió @darkspark5127point: probar una variante tras otra y acumular puntuaciones en lugar de resolver la cuestión de la autoría. Si alguien realmente pone en duda que lo hayas escrito tú, ningún resultado de un detector zanja el asunto. Tus notas y la propia configuración sí.