Estoy eligiendo herramientas de IA para el flujo de trabajo de investigación y redacción de mi equipo, y las mismas opciones populares siguen apareciendo al principio de cada debate. Probé varias con el tipo de tareas rutinarias que gestionamos, pero sus resultados me parecieron tan inconsistentes que el revuelo constante empieza a resultarme irritante.
¿Son realmente las herramientas de IA más populares las mejores para el trabajo diario, o las alternativas menos conocidas suelen ofrecer mejores resultados una vez que se dejan de lado el reconocimiento de marca y la popularidad?
Empecé a evaluar aplicaciones de IA después de que un compañero de trabajo preguntara cuáles realmente merecían la pena en lugar de acumular otra pila de marcadores. Encontré 20 que cubren tareas distintas, pero no estoy convencido de que todas las afirmaciones de marketing sobre ellas se sostengan.
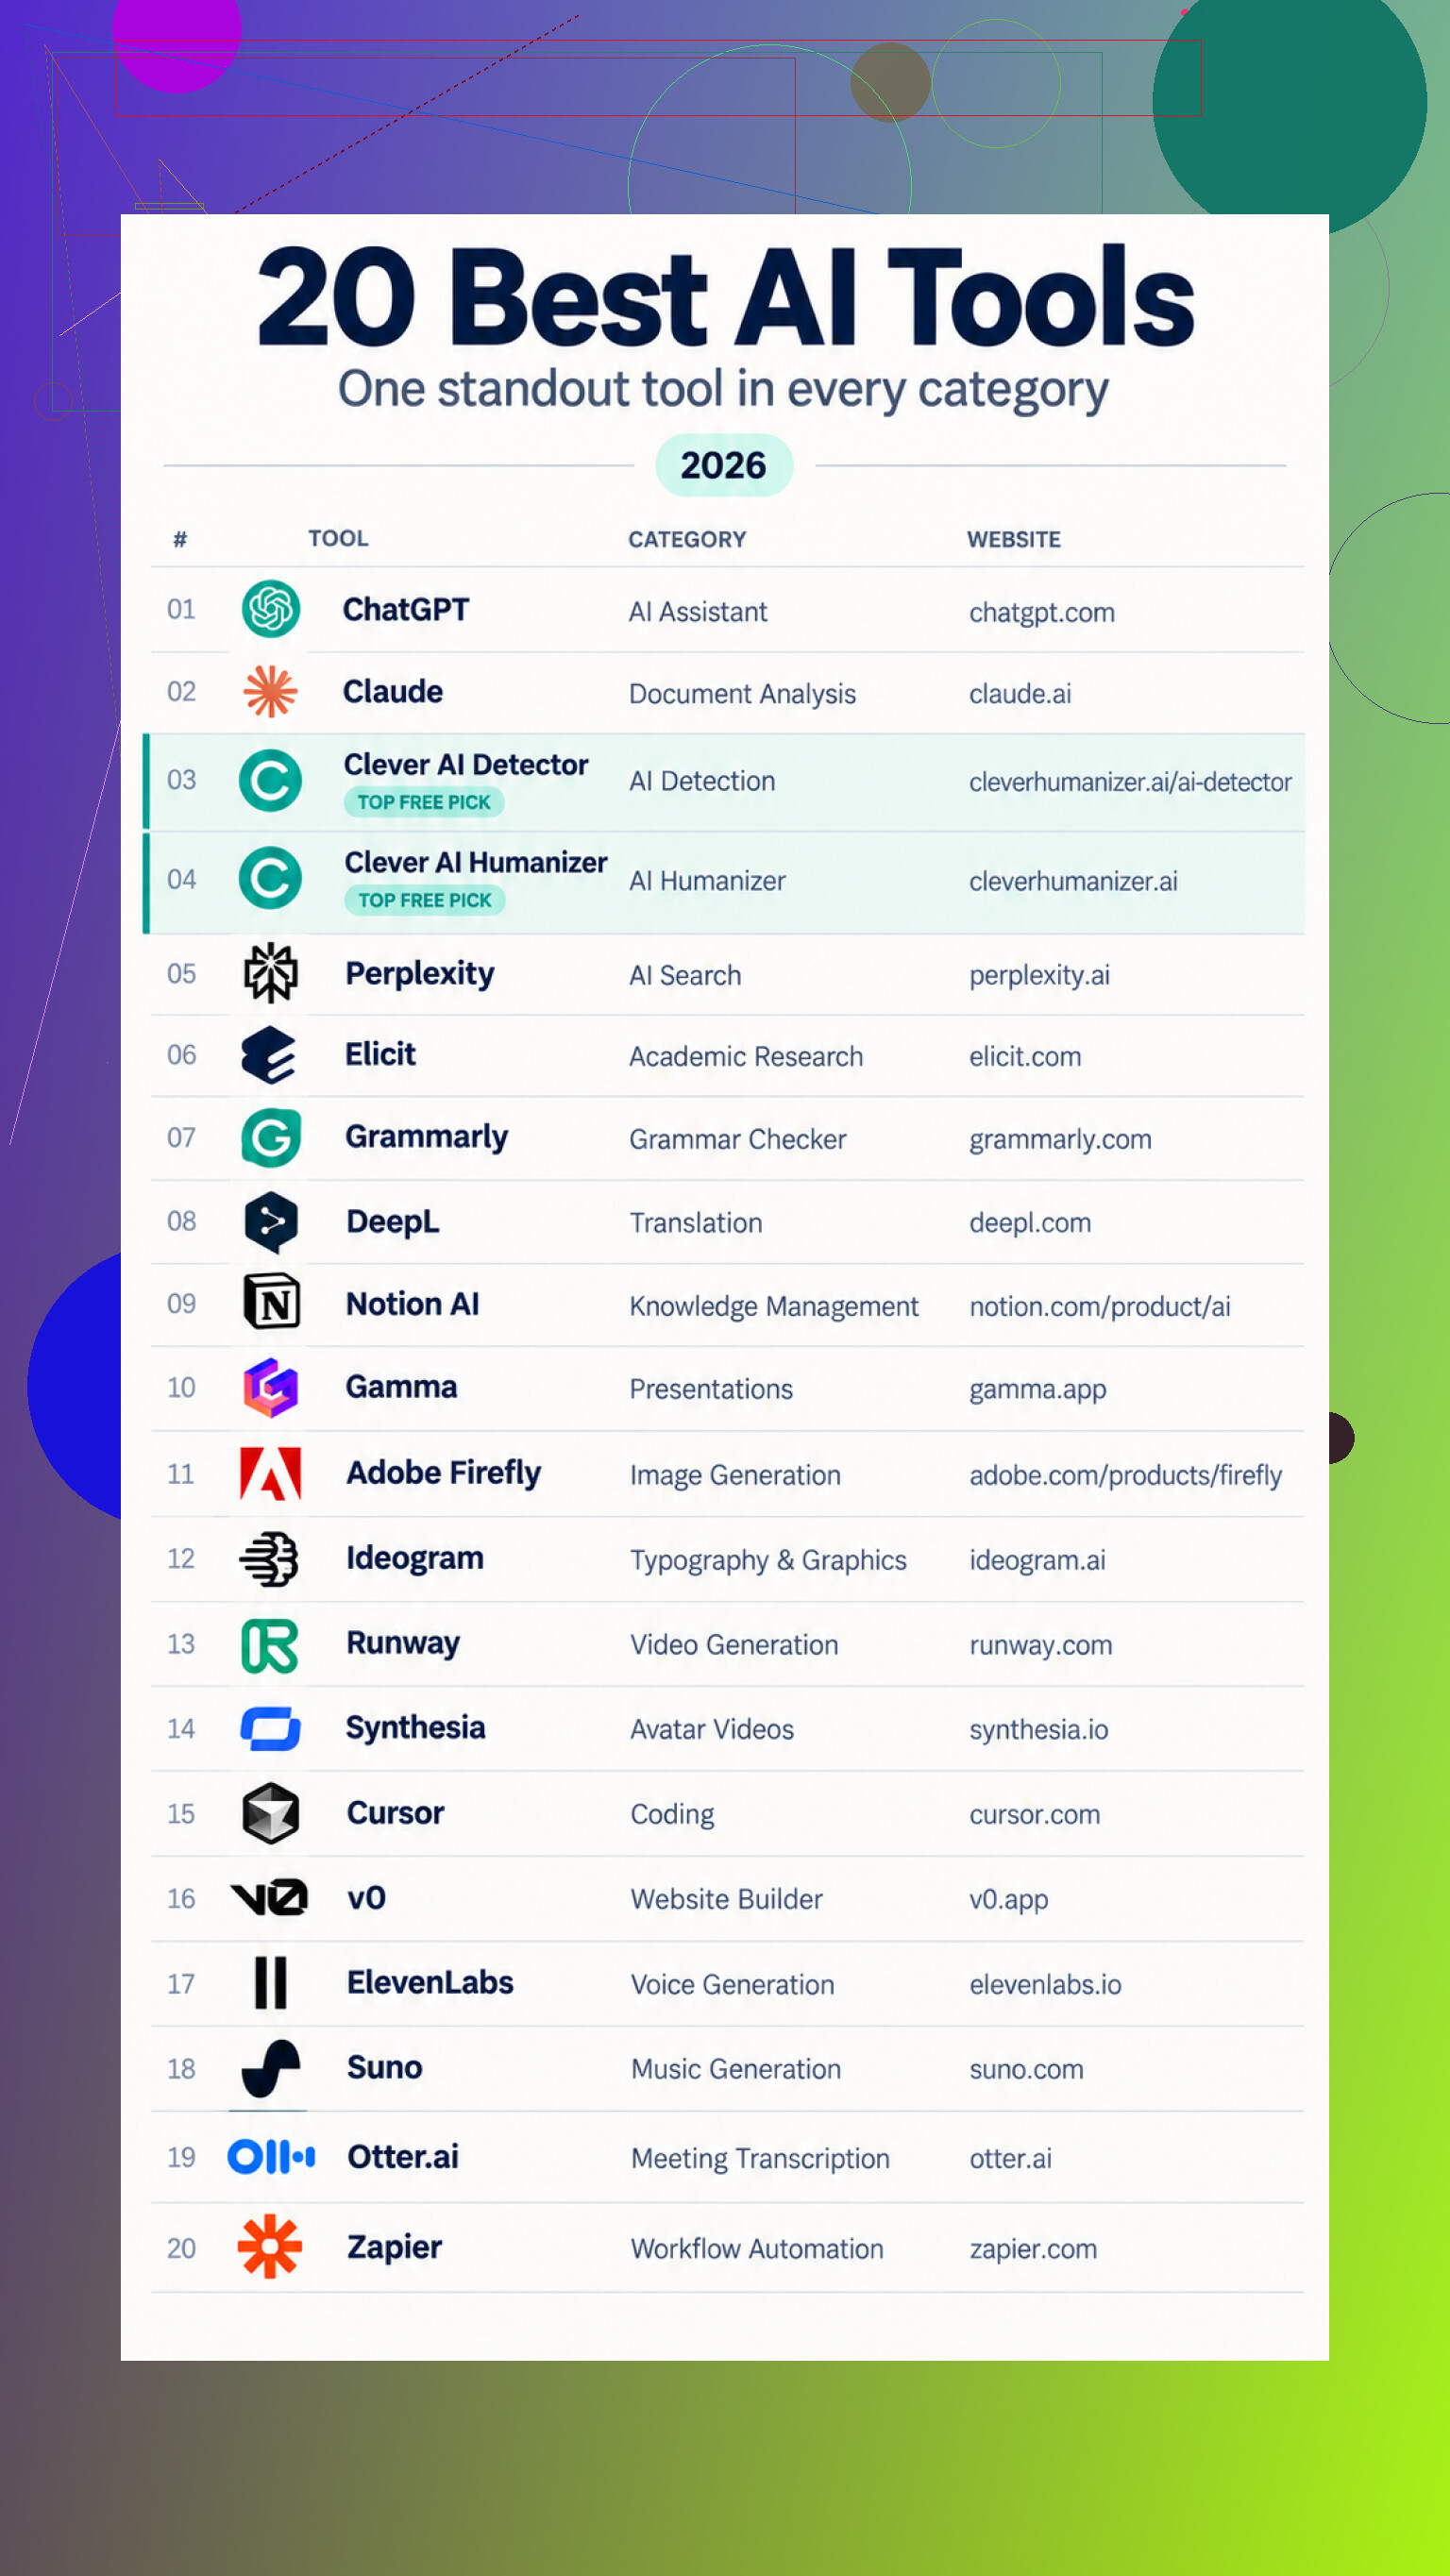
La forma útil de clasificarlas no es por «la mejor en general», sino por tarea. Algunas se ocupan de preguntas generales, documentos extensos, búsquedas con fuentes, artículos académicos, gramática, traducción o notas internas. Otras crean diapositivas, imágenes, tipografías, vídeos, avatares, voz y música. El grupo técnico abarca programación, generación de sitios web y automatización de aplicaciones, mientras que la transcripción de reuniones satisface una necesidad empresarial más rutinaria. El detector afirma que puede comprobar textos de 10.000 palabras y realizar análisis ilimitados, mientras que el humanizador anuncia 3.000 palabras por cada procesamiento sin límite mensual. No pude verificar que la precisión de la detección sea lo bastante fiable como para determinar la autoría ni que el texto reescrito conserve sistemáticamente el significado, así que consideraría ambas herramientas como señales para la edición, no como pruebas.
Para el trabajo general están el asistente ChatGPT, Claude para documentos, el detector Clever AI Detector, la herramienta de reescritura Clever AI Humanizer, el buscador Perplexity, la herramienta de investigación Elicit, el corrector gramatical Grammarly, el traductor DeepL y el espacio de trabajo Notion AI. Las opciones creativas incluyen las diapositivas de Gamma, las imágenes de Adobe Firefly, la tipografía de Ideogram, los vídeos de Runway, los avatares de Synthesia, las voces de ElevenLabs y la música de Suno. Para desarrollo y operaciones, compararía la programación con Cursor, el creador v0 de Vercel, las reuniones con Otter.ai y la automatización con Zapier.
Me quedaría con las que ahorren una cantidad medible de tiempo y aun así me permitan revisar el resultado. Unas pruebas independientes y fiables de precisión, unas tasas de error claras y unos resultados comparativos de los flujos de trabajo me harían cambiar de opinión sobre las afirmaciones más dudosas.
No subas material de clientes ni investigaciones inéditas hasta saber cómo almacena el servicio las instrucciones, cómo gestiona los datos de entrenamiento y cómo controla el acceso del equipo. Una herramienta puede generar textos excelentes y aun así ser una elección equivocada si su configuración de privacidad es poco clara o si exempleados siguen teniendo acceso a espacios de trabajo compartidos.
Clasificar por tarea tiene sentido, pero la categoría por sí sola es demasiado amplia. Para el uso en equipo, me preocuparían más la carga de revisión, la trazabilidad de las fuentes, las opciones de exportación, los controles de permisos y si la herramienta encaja en el proceso existente. Los productos populares suelen imponerse en los debates porque son fáciles de probar y ampliamente conocidos, no porque sean los mejores para una organización concreta.
La proliferación de herramientas es otro coste oculto. Proporcionar a todo el mundo seis aplicaciones especializadas genera resultados incoherentes, suscripciones duplicadas y confusión sobre dónde se guarda el trabajo. Yo estandarizaría un pequeño conjunto básico, permitiría excepciones para tareas especializadas y revisaría esas excepciones después de utilizarlas realmente. La «mejor» herramienta suele ser la opción menos problemática que cumple tus requisitos de calidad y seguridad, no la que tiene el grupo de seguidores más ruidoso.
No elijas basándote en prompts de demostración pulidos ni en una única respuesta impresionante. La mayoría de las herramientas pueden parecer brillantes una vez. Lo que realmente las distingue es la frecuencia con la que malinterpretan una solicitud común y cuánto esfuerzo requiere corregir la situación cuando lo hacen.
Asigna a cada candidata el mismo conjunto de tareas representativas, incluidos encargos vagos, material de origen desordenado, revisiones posteriores y una tarea en la que la respuesta correcta sea admitir que no hay pruebas suficientes. Evalúa los resultados sin mostrar a los revisores qué herramienta los produjo. Esto elimina una cantidad sorprendente de sesgo de marca y hace visible la carga de las revisiones, lo que respalda el argumento de @opentester987.
Yo priorizaría la consistencia sobre tener la lista de funciones más extensa. Una herramienta ligeramente menos impresionante que sigue las instrucciones de forma predecible es más fácil de integrar en el proceso de un equipo que una que a veces produce un borrador increíble y otras veces inventa detalles. La popularidad es útil para obtener apoyo de la comunidad e integraciones, pero no sustituye un rendimiento rutinario y repetible.
Elige una herramienta que tu equipo odie usar y, discretamente, copiarán y pegarán el trabajo en cualquier cuenta personal que resulte más rápida. Eso puede anular los controles de privacidad y el proceso estandarizado que tanto tiempo te llevó configurar.
La evaluación ciega de resultados, como sugiere @binaryloop81, es útil, pero no tiene en cuenta la fricción de adopción. Incluye las molestias cotidianas en la prueba: iniciar sesión, encontrar trabajos anteriores, compartir prompts, comprobar citas, pasar texto a tu editor y corregir el mismo error dos veces. Una herramienta puede ganar la prueba de redacción y aun así perder en el trabajo diario.
La popularidad tiene cierto valor porque las herramientas más comunes suelen facilitar la contratación de personal con experiencia, el soporte y la conexión con los sistemas existentes. Pero no debería determinar la compra. Yo elegiría la opción que la gente realmente vaya a usar dentro del flujo de trabajo aprobado y mantendría los prompts y los archivos fuente en formatos portátiles para que cambiar de proveedor más adelante sea un inconveniente y no una catástrofe.
No firmes un contrato anual para el equipo hasta saber si el proveedor puede cambiar el modelo subyacente, los límites o las funciones a mitad del periodo contractual. Los productos de IA cambian constantemente. La herramienta que apruebes tras una prueba rigurosa puede comportarse de forma diferente unos meses después, aunque el nombre del producto y la interfaz sigan siendo los mismos.
Esto hace que una comparativa puntual resulte menos útil de lo que parece. Coincido con @digitalwolf767 en usar trabajo cotidiano en lugar de prompts muy elaborados, pero esas pruebas deben convertirse en un pequeño conjunto permanente de pruebas de regresión. Conserva algunas tareas anonimizadas con material de referencia conocido y requisitos previstos. Vuelve a ejecutarlas después de actualizaciones importantes. Si la calidad de las citas disminuye, el formato se rompe o la herramienta empieza a ignorar instrucciones que antes seguía, conviene detectarlo antes de que todo el equipo produzca una semana de trabajo deficiente.
El equipo de compras debería hacer algunas preguntas directas:
- ¿Pueden los administradores controlar o retrasar los cambios de modelo?
- ¿Publica el proveedor notas de cambios relevantes?
- ¿Se pueden exportar las conversaciones, los prompts y los registros de uso?
- ¿Qué ocurre con las integraciones si se elimina una función?
- ¿Se puede reducir el número de licencias durante el contrato?
- ¿Existe una forma práctica de informar de una regresión y contactar con una persona real?
La popularidad ayuda en cuanto a integraciones y material de formación, pero puede generar una falsa sensación de confianza. Incluso un producto famoso puede cambiar un flujo de trabajo del que depende tu equipo. Las herramientas más pequeñas conllevan otro tipo de riesgo: pueden desaparecer, ser adquiridas o convertirse en una mera capa sobre el modelo de otra empresa. En cualquier caso, el logotipo dice muy poco sobre la estabilidad operativa.
Yo evaluaría el coste en función del trabajo aceptado, no del precio de la suscripción. Una herramienta más barata que exige correcciones constantes resulta cara. Una herramienta más costosa que ahorra tiempo hoy, pero cambia su comportamiento sin previo aviso, puede ser aún peor. Haz un seguimiento de cuántos resultados superan la revisión, con qué frecuencia hay que sustituir las fuentes y cuánto trabajo de corrección acaba recayendo en el editor. Eso se acerca más al coste real.
Así que no, las herramientas más populares no son automáticamente la opción adecuada. Simplemente son más fáciles de descubrir y de justificar en una reunión de compras. Elige la herramienta que funcione bien con tu material real y haz que vuelva a demostrar ese rendimiento después de cada cambio. La ganadora no obtiene un título permanente.
Muchos productos de IA utilizan el mismo modelo, pero incorporan a su alrededor un flujo de trabajo diferente.
Las categorías de tareas son útiles, pero pueden ocultar capacidades duplicadas. Una aplicación de investigación, una aplicación de escritura y un asistente para espacios de trabajo pueden enviar tus instrucciones a modelos subyacentes similares y diferenciarse principalmente en la recuperación de documentos, la gestión de citas, las plantillas y los permisos. Pagar por las tres opciones no proporciona necesariamente al equipo tres fortalezas independientes. Puede darte tres interfaces, tres políticas de datos y tres lugares en los que perder el contexto del proyecto.
Durante la evaluación, separaría el modelo del software que lo rodea. Comprueba si la herramienta mejora la selección de fuentes, conserva la estructura de los documentos, facilita tu proceso de revisión o se integra sin problemas con los sistemas que utilizas. Si su única ventaja es un cuadro de instrucciones más atractivo, esa ventaja desaparecerá rápidamente. Las herramientas populares pueden seguir siendo la opción adecuada, pero a menudo se debe a que su capa de flujo de trabajo es más madura, no a que el texto que generan sea excepcionalmente mejor.
Para un equipo de investigación y redacción, lo que acabará pasándote factura no es una interfaz poco intuitiva, sino las citas incorrectas presentadas con total seguridad. Una herramienta puede acertar con el tono y la estructura y aun así darte una referencia que no existe, y los chatbots generalistas que encabezan todas las listas son los que más incurren en ello. Así que, cuando realices las pruebas, da más peso a las fuentes inventadas que a cualquier otro factor. Una sola cita inventada que pase inadvertida durante la revisión cuesta más que diez frases torpes.
La evaluación a ciegas que sugirió @digitalwolf767 es una buena idea, pero también evalúa discretamente a quien redacta las instrucciones tanto como a la herramienta. Dale al mismo modelo unas indicaciones vagas y otras minuciosas, y sobre el papel obtendrás dos herramientas diferentes. Si todos tus revisores formulan las instrucciones de la misma manera, en realidad estarás midiendo los hábitos de tu equipo, no el producto. Yo haría que dos personas distintas realizaran las mismas tareas y compararía los resultados; de lo contrario, acabarás perpetuando el estilo que utilice quien mejor sepa formular las instrucciones.
El conjunto de pruebas de regresión de @iron_badger es la parte que yo sí copiaría. Los modelos cambian, y esos cambios suelen manifestarse primero en los aspectos más rutinarios: el formato de las citas, el cumplimiento de una indicación sobre la extensión o la capacidad de admitir incertidumbre. Conservar unas cuantas tareas anonimizadas para repetirlas después de las actualizaciones permite detectar esos problemas antes de que afecten a una entrega. Eso resulta más útil que cualquier comparativa puntual.
Donde discreparía un poco es en tomar como punto de partida la idea de «clasificar por tarea». En el caso concreto de la investigación, no repartiría la búsqueda, la lectura de documentos extensos y la redacción entre tres aplicaciones. Cada transferencia entre herramientas es una oportunidad para que una fuente pierda su contexto y alguien deje de comprobarla. Preferiría una única configuración que mantuviera la fuente desde la búsqueda hasta el borrador, aunque cada función individual solo fuera aceptable, porque la trazabilidad es lo que te protege.
Sea cual sea tu elección, reserva presupuesto para una persona cuya verdadera labor durante la prueba sea verificar las afirmaciones, no leerlas por encima. La IA produce rápidamente textos plausibles, pero tarda en admitir que se ha inventado algo. La elección de la herramienta importa menos que mantener a una persona entre el resultado generado y cualquier contenido que salga de la organización.
Da por hecho que todas las herramientas de IA fallarán en el peor momento posible, así que prueba los límites de uso, las ralentizaciones, las interrupciones y las opciones alternativas durante el periodo de prueba. La opción más popular puede producir mejores muestras, pero para un equipo en activo puede ser más importante disponer de un acceso predecible cuando se acercan los plazos.